Java基础2
五、面向对象基础
1. 面向对象和面向过程的区别
面向过程编程(Procedural-Oriented Programming,POP)和面向对象编程(Object-Oriented Programming,OOP)是两种常见的编程范式,两者的主要区别在于解决问题的方式不同:
- 面向过程编程(POP):面向过程把解决问题的过程拆成一个个方法,通过一个个方法的执行解决问题。
- 面向对象编程(OOP):面向对象会先抽象出对象,然后用对象执行方法的方式解决问题。
相比较于 POP,OOP 开发的程序一般具有下面这些优点:
- 易维护:由于良好的结构和封装性,OOP 程序通常更容易维护。
- 易复用:通过继承和多态,OOP 设计使得代码更具复用性,方便扩展功能。
- 易扩展:模块化设计使得系统扩展变得更加容易和灵活。
POP 的编程方式通常更为简单和直接,适合处理一些较简单的任务。
POP 和 OOP 的性能差异主要取决于它们的运行机制,而不仅仅是编程范式本身。因此,简单地比较两者的性能是一个常见的误区。
在选择编程范式时,性能并不是唯一的考虑因素。代码的可维护性、可扩展性和开发效率同样重要。
现代编程语言基本都支持多种编程范式,既可以用来进行面向过程编程,也可以进行面向对象编程。
下面是一个求圆的面积和周长的示例,简单分别展示了面向对象和面向过程两种不同的解决方案。
面向对象:
public class Circle {
    // 定义圆的半径
    private double radius;

    // 构造函数
    public Circle(double radius) {
        this.radius = radius;
    }

    // 计算圆的面积
    public double getArea() {
        return Math.PI * radius * radius;
    }

    // 计算圆的周长
    public double getPerimeter() {
        return 2 * Math.PI * radius;
    }

    public static void main(String[] args) {
        // 创建一个半径为3的圆
        Circle circle = new Circle(3.0);

        // 输出圆的面积和周长
        System.out.println("圆的面积为:" + circle.getArea());
        System.out.println("圆的周长为:" + circle.getPerimeter());
    }
}
我们定义了一个 Circle 类来表示圆,该类包含了圆的半径属性和计算面积、周长的方法。
面向过程:
public class Main {
    public static void main(String[] args) {
        // 定义圆的半径
        double radius = 3.0;

        // 计算圆的面积和周长
        double area = Math.PI * radius * radius;
        double perimeter = 2 * Math.PI * radius;

        // 输出圆的面积和周长
        System.out.println("圆的面积为:" + area);
        System.out.println("圆的周长为:" + perimeter);
    }
}
我们直接定义了圆的半径,并使用该半径直接计算出圆的面积和周长。
2. 创建一个对象用什么运算符?对象实例与对象引用有何不同?
new 运算符,new 创建对象实例(对象实例在堆内存中),对象引用指向对象实例(对象引用存放在栈内存中)。
- 一个对象引用可以指向 0 个或 1 个对象(一根绳子可以不系气球,也可以系一个气球);
- 一个对象可以有 n 个引用指向它(可以用 n 条绳子系住一个气球)。
3. 对象的相等和引用相等的区别
- 对象的相等一般比较的是内存中存放的内容是否相等。
- 引用相等一般比较的是他们指向的内存地址是否相等。
这里举一个例子:
String str1 = "hello";
String str2 = new String("hello");
String str3 = "hello";
// 使用 == 比较字符串的引用相等
System.out.println(str1 == str2);
System.out.println(str1 == str3);
// 使用 equals 方法比较字符串的相等
System.out.println(str1.equals(str2));
System.out.println(str1.equals(str3));
输出结果:
false
true
true
true
从上面的代码输出结果可以看出:
str1和str2不相等,而str1和str3相等。这是因为==运算符比较的是字符串的引用是否相等。str1、str2、str3三者的内容都相等。这是因为equals方法比较的是字符串的内容,即使这些字符串的对象引用不同,只要它们的内容相等,就认为它们是相等的。
4. 如果一个类没有声明构造方法,该程序能正确执行吗?
构造方法是一种特殊的方法,主要作用是完成对象的初始化工作。
如果一个类没有声明构造方法,也可以执行!因为一个类即使没有声明构造方法也会有默认的不带参数的构造方法。如果我们自己添加了类的构造方法(无论是否有参),Java 就不会添加默认的无参数的构造方法了。
我们一直在不知不觉地使用构造方法,这也是为什么我们在创建对象的时候后面要加一个括号(因为要调用无参的构造方法)。如果我们重载了有参的构造方法,记得都要把无参的构造方法也写出来(无论是否用到),因为这可以帮助我们在创建对象的时候少踩坑。
5. 构造方法有哪些特点?是否可被 override?
构造方法具有以下特点:
- 名称与类名相同:构造方法的名称必须与类名完全一致。
- 没有返回值:构造方法没有返回类型,且不能使用
void声明。 - 自动执行:在生成类的对象时,构造方法会自动执行,无需显式调用。
构造方法不能被重写(override),但可以被重载(overload)。因此,一个类中可以有多个构造方法,这些构造方法可以具有不同的参数列表,以提供不同的对象初始化方式。
6. 面向对象三大特征
封装
封装是指把一个对象的状态信息(也就是属性)隐藏在对象内部,不允许外部对象直接访问对象的内部信息。但是可以提供一些可以被外界访问的方法来操作属性。
public class Person {
    private String name;  // 私有属性
    private int age;

    // 提供公共的方法访问私有属性(getter 和 setter)
    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        if (age >= 0) {  // 数据校验,防止非法值
            this.age = age;
        }
    }
}
继承
继承是指子类继承父类的属性和方法,从而复用已有代码,并扩展新功能。
// 父类
class Animal {
    String name;

    public void eat() {
        System.out.println(name + " is eating...");
    }
}

// 子类继承父类
class Dog extends Animal {
    public void bark() {
        System.out.println(name + " is barking...");
    }
}

// 测试
public class Test {
    public static void main(String[] args) {
        Dog dog = new Dog();
        dog.name = "Buddy";
        dog.eat();  // 继承自父类的方法
        dog.bark(); // 子类独有的方法
    }
}
示例分析:
Dog继承Animal,因此 无需重复编写eat()方法,减少代码冗余。Dog还可以添加自己的方法bark(),扩展功能。
注意:
- Java 只支持 单继承(一个类只能继承一个父类),但可以 多层继承。
- 使用
super关键字调用父类方法。
多态
多态指的是同一接口,不同实现,即相同的方法在不同对象上有不同的表现形式。 多态可以通过 方法重写(Override) 和 方法重载(Overload) 实现。
方法重写(Override)
子类 重写(覆盖)父类的方法,以实现不同的行为。
方法重载(Overload)
同一个类 里,方法名相同,但参数不同(参数个数或类型不同)。
| 特性 | 作用 | 关键点 |
|---|---|---|
| 封装 | 保护数据,隐藏实现细节 | private、getter/setter |
| 继承 | 代码复用,扩展功能 | extends 关键字 |
| 多态 | 相同接口,不同实现 | 方法重写(Override)、方法重载(Overload) |
7. 接口和抽象类有什么共同点和区别?
接口和抽象类的共同点
- 实例化:接口和抽象类都不能直接实例化,只能被实现(接口)或继承(抽象类)后才能创建具体的对象。
- 抽象方法:接口和抽象类都可以包含抽象方法。抽象方法没有方法体,必须在子类或实现类中实现。
接口和抽象类的区别
-
设计目的:接口主要用于对类的行为进行约束,你实现了某个接口就具有了对应的行为。抽象类主要用于代码复用,强调的是所属关系。
-
继承和实现:一个类只能继承一个类(包括抽象类),因为 Java 不支持多继承。但一个类可以实现多个接口,一个接口也可以继承多个其他接口。
-
成员变量:接口中的成员变量只能是
public static final类型的,不能被修改且必须有初始值。抽象类的成员变量可以有任何修饰符(private,protected,public),可以在子类中被重新定义或赋值。 -
方法:
- Java 8 之前,接口中的方法默认是
public abstract,也就是只能有方法声明。自 Java 8 起,可以在接口中定义default(默认) 方法和static(静态)方法。 自 Java 9 起,接口可以包含private方法。
- Java 8 之前,接口中的方法默认是
-
抽象类可以包含抽象方法和非抽象方法。抽象方法没有方法体,必须在子类中实现。非抽象方法有具体实现,可以直接在抽象类中使用或在子类中重写。
在 Java 8 及以上版本中,接口引入了新的方法类型:default 方法、static 方法和 private 方法。这些方法让接口的使用更加灵活。
Java 8 引入的default 方法用于提供接口方法的默认实现,可以在实现类中被覆盖。这样就可以在不修改实现类的情况下向现有接口添加新功能,从而增强接口的扩展性和向后兼容性。
public interface MyInterface {
    default void defaultMethod() {
        System.out.println("This is a default method.");
    }
}
Java 8 引入的static 方法无法在实现类中被覆盖,只能通过接口名直接调用( MyInterface.staticMethod()),类似于类中的静态方法。static 方法通常用于定义一些通用的、与接口相关的工具方法,一般很少用。
public interface MyInterface {
    static void staticMethod() {
        System.out.println("This is a static method in the interface.");
    }
}
Java 9 允许在接口中使用 private 方法。private方法可以用于在接口内部共享代码,不对外暴露。
public interface MyInterface {
    // default 方法
    default void defaultMethod() {
        commonMethod();
    }

    // static 方法
    static void staticMethod() {
        commonMethod();
    }

    // 私有静态方法,可以被 static 和 default 方法调用
    private static void commonMethod() {
        System.out.println("This is a private method used internally.");
    }

      // 实例私有方法,只能被 default 方法调用。
    private void instanceCommonMethod() {
        System.out.println("This is a private instance method used internally.");
    }
}
8. 深拷贝和浅拷贝区别了解吗?什么是引用拷贝?
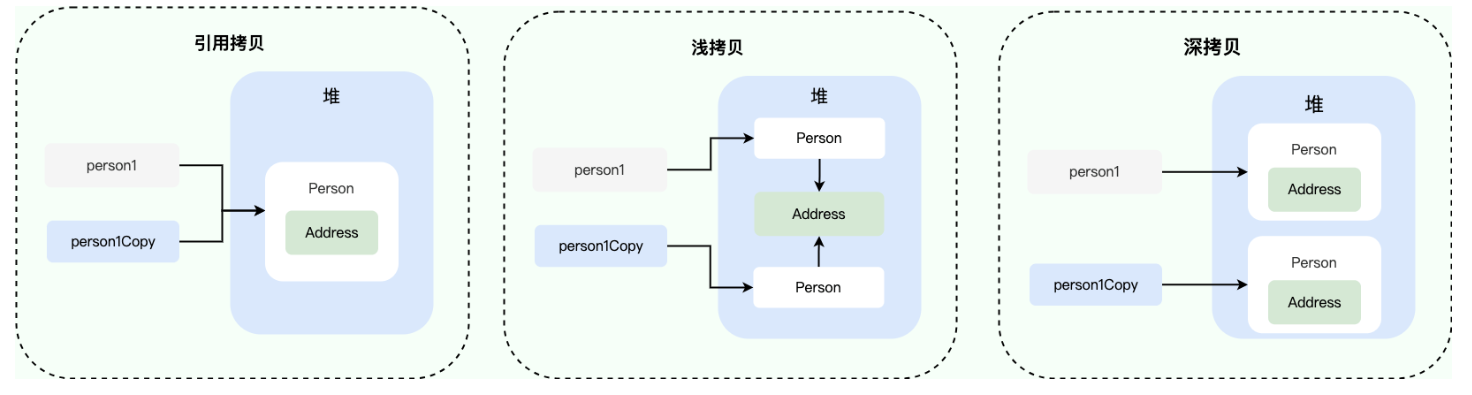
关于深拷贝和浅拷贝区别,我这里先给结论:
- 浅拷贝:浅拷贝会在堆上创建一个新的对象(区别于引用拷贝的一点),不过,如果原对象内部的属性是引用类型的话,浅拷贝会直接复制内部对象的引用地址,也就是说拷贝对象和原对象共用同一个内部对象。
- 深拷贝:深拷贝会完全复制整个对象,包括这个对象所包含的内部对象。
浅拷贝
浅拷贝的示例代码如下,我们这里实现了 Cloneable 接口,并重写了 clone() 方法。
clone() 方法的实现很简单,直接调用的是父类 Object 的 clone() 方法。
public class Address implements Cloneable{
    private String name;
    // 省略构造函数、Getter&Setter方法
    @Override
    public Address clone() {
        try {
            return (Address) super.clone();
        } catch (CloneNotSupportedException e) {
            throw new AssertionError();
        }
    }
}

public class Person implements Cloneable {
    private Address address;
    // 省略构造函数、Getter&Setter方法
    @Override
    public Person clone() {
        try {
            Person person = (Person) super.clone();
            return person;
        } catch (CloneNotSupportedException e) {
            throw new AssertionError();
        }
    }
}
测试:
Person person1 = new Person(new Address("武汉"));
Person person1Copy = person1.clone();
// true
System.out.println(person1.getAddress() == person1Copy.getAddress());
从输出结构就可以看出, person1 的克隆对象和 person1 使用的仍然是同一个 Address 对象。
深拷贝
这里我们简单对 Person 类的 clone() 方法进行修改,连带着要把 Person 对象内部的 Address 对象一起复制。
@Override
public Person clone() {
    try {
        Person person = (Person) super.clone();
        person.setAddress(person.getAddress().clone());
        return person;
    } catch (CloneNotSupportedException e) {
        throw new AssertionError();
    }
}
测试:
Person person1 = new Person(new Address("武汉"));
Person person1Copy = person1.clone();
// false
System.out.println(person1.getAddress() == person1Copy.getAddress());
从输出结构就可以看出,显然 person1 的克隆对象和 person1 包含的 Address 对象已经是不同的了。
那什么是引用拷贝呢? 简单来说,引用拷贝就是两个不同的引用指向同一个对象。
六、Object
1. Object 类的常见方法有哪些?
Object 类是一个特殊的类,是所有类的父类,主要提供了以下 11 个方法:
/**
 * native 方法,用于返回当前运行时对象的 Class 对象,使用了 final 关键字修饰,故不允许子类重写。
 */
public final native Class<?> getClass()
/**
 * native 方法,用于返回对象的哈希码,主要使用在哈希表中,比如 JDK 中的HashMap。
 */
public native int hashCode()
/**
 * 用于比较 2 个对象的内存地址是否相等,String 类对该方法进行了重写以用于比较字符串的值是否相等。
 */
public boolean equals(Object obj)
/**
 * native 方法,用于创建并返回当前对象的一份拷贝。
 */
protected native Object clone() throws CloneNotSupportedException
/**
 * 返回类的名字实例的哈希码的 16 进制的字符串。建议 Object 所有的子类都重写这个方法。
 */
public String toString()
/**
 * native 方法,并且不能重写。唤醒一个在此对象监视器上等待的线程(监视器相当于就是锁的概念)。如果有多个线程在等待只会任意唤醒一个。
 */
public final native void notify()
/**
 * native 方法,并且不能重写。跟 notify 一样,唯一的区别就是会唤醒在此对象监视器上等待的所有线程,而不是一个线程。
 */
public final native void notifyAll()
/**
 * native方法,并且不能重写。暂停线程的执行。注意:sleep 方法没有释放锁,而 wait 方法释放了锁 ,timeout 是等待时间。
 */
public final native void wait(long timeout) throws InterruptedException
/**
 * 多了 nanos 参数,这个参数表示额外时间(以纳秒为单位,范围是 0-999999)。 所以超时的时间还需要加上 nanos 纳秒。。
 */
public final void wait(long timeout, int nanos) throws InterruptedException
/**
 * 跟之前的2个wait方法一样,只不过该方法一直等待,没有超时时间这个概念
 */
public final void wait() throws InterruptedException
/**
 * 实例被垃圾回收器回收的时候触发的操作
 */
protected void finalize() throws Throwable { }
2. == 和 equals() 的区别
== 用于比较两个变量是否指向同一个内存地址(即是否是同一个对象)。
- 基本数据类型:
==比较的是值是否相等。 - 引用数据类型(对象):
==比较的是两个对象的引用地址是否相同,而不是对象的内容是否相同。
equals() 是 Object 类中的方法,默认行为与 == 一样(即比较内存地址)。
许多类(如 String、Integer 等)都重写了 equals(),使其比较的是内容,而不是地址。
如果需要自定义对象的内容比较,一般需要重写 equals() 方法。
| 比较方式 | 适用类型 | 比较内容 | 是否可重写 |
|---|---|---|---|
== | 基本数据类型 | 值 | ❌ |
== | 引用数据类型 | 内存地址 | ❌ |
equals()(默认) | 引用数据类型 | 内存地址 | ❌ |
equals()(重写) | 引用数据类型 | 对象内容 | ✅ |
3. hashCode() 有什么用?
hashCode() 的作用是获取哈希码(int 整数),也称为散列码。这个哈希码的作用是确定该对象在哈希表中的索引位置。
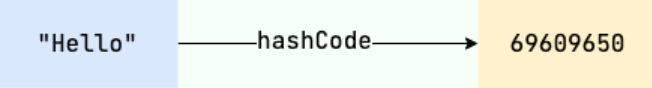
hashCode() 定义在 JDK 的 Object 类中,这就意味着 Java 中的任何类都包含有 hashCode() 函数。另外需要注意的是:Object 的 hashCode() 方法是本地方法,也就是用 C 语言或 C++ 实现的。
public native int hashCode();
散列表存储的是键值对(key-value),它的特点是:能根据“键”快速的检索出对应的“值”。这其中就利用到了散列码!(可以快速找到所需要的对象)
4. 为什么要有 hashCode?
我们以“HashSet 如何检查重复”为例子来说明为什么要有 hashCode?
下面这段内容摘自我的 Java 启蒙书《Head First Java》:
当你把对象加入
HashSet时,HashSet会先计算对象的hashCode值来判断对象加入的位置,同时也会与其他已经加入的对象的hashCode值作比较,如果没有相符的hashCode,HashSet会假设对象没有重复出现。但是如果发现有相同hashCode值的对象,这时会调用equals()方法来检查hashCode相等的对象是否真的相同。如果两者相同,HashSet就不会让其加入操作成功。如果不同的话,就会重新散列到其他位置。这样我们就大大减少了equals的次数,相应就大大提高了执行速度。
其实, hashCode() 和 equals()都是用于比较两个对象是否相等。
那为什么 JDK 还要同时提供这两个方法呢?
这是因为在一些容器(比如 HashMap、HashSet)中,有了 hashCode() 之后,判断元素是否在对应容器中的效率会更高(参考添加元素进HashSet的过程)!
我们在前面也提到了添加元素进HashSet的过程,如果 HashSet 在对比的时候,同样的 hashCode 有多个对象,它会继续使用 equals() 来判断是否真的相同。也就是说 hashCode 帮助我们大大缩小了查找成本。
那为什么不只提供 hashCode() 方法呢?
这是因为两个对象的hashCode 值相等并不代表两个对象就相等。
那为什么两个对象有相同的 hashCode 值,它们也不一定是相等的?
因为 hashCode() 所使用的哈希算法也许刚好会让多个对象传回相同的哈希值。越糟糕的哈希算法越容易碰撞,但这也与数据值域分布的特性有关(所谓哈希碰撞也就是指的是不同的对象得到相同的 hashCode )。
总结下来就是:
- 如果两个对象的
hashCode值相等,那这两个对象不一定相等(哈希碰撞)。 - 如果两个对象的
hashCode值相等并且equals()方法也返回true,我们才认为这两个对象相等。 - 如果两个对象的
hashCode值不相等,我们就可以直接认为这两个对象不相等。
相信大家看了我前面对 hashCode() 和 equals() 的介绍之后,下面这个问题已经难不倒你们了。
5. 为什么重写 equals() 时必须重写 hashCode() 方法?
因为两个相等的对象的 hashCode 值必须是相等。也就是说如果 equals 方法判断两个对象是相等的,那这两个对象的 hashCode 值也要相等。
如果重写 equals() 时没有重写 hashCode() 方法的话就可能会导致 equals 方法判断是相等的两个对象,hashCode 值却不相等。
思考:重写 equals() 时没有重写 hashCode() 方法的话,使用 HashMap 可能会出现什么问题。
总结:
equals方法判断两个对象是相等的,那这两个对象的hashCode值也要相等。- 两个对象有相同的
hashCode值,他们也不一定是相等的(哈希碰撞)。
更多关于 hashCode() 和 equals() 的内容可以查看:Java hashCode() 和 equals()的若干问题解答
七、String
1. String、StringBuffer、StringBuilder 的区别?
可变性
String 是不可变的(后面会详细分析原因)。
StringBuilder 与 StringBuffer 都继承自 AbstractStringBuilder 类,在 AbstractStringBuilder 中也是使用字符数组保存字符串,不过没有使用 final 和 private 关键字修饰,最关键的是这个 AbstractStringBuilder 类还提供了很多修改字符串的方法比如 append 方法。
abstract class AbstractStringBuilder implements Appendable, CharSequence {
    char[] value;
    public AbstractStringBuilder append(String str) {
        if (str == null)
            return appendNull();
        int len = str.length();
        ensureCapacityInternal(count + len);
        str.getChars(0, len, value, count);
        count += len;
        return this;
    }
    //...
}
线程安全性
String 中的对象是不可变的,也就可以理解为常量,线程安全。AbstractStringBuilder 是 StringBuilder 与 StringBuffer 的公共父类,定义了一些字符串的基本操作,如 expandCapacity、append、insert、indexOf 等公共方法。StringBuffer 对方法加了同步锁或者对调用的方法加了同步锁,所以是线程安全的。StringBuilder 并没有对方法进行加同步锁,所以是非线程安全的。
性能
每次对 String 类型进行改变的时候,都会生成一个新的 String 对象,然后将指针指向新的 String 对象。StringBuffer 每次都会对 StringBuffer 对象本身进行操作,而不是生成新的对象并改变对象引用。相同情况下使用 StringBuilder 相比使用 StringBuffer 仅能获得 10%~15% 左右的性能提升,但却要冒多线程不安全的风险。
对于三者使用的总结:
- 操作少量的数据: 适用
String - 单线程操作字符串缓冲区下操作大量数据: 适用
StringBuilder - 多线程操作字符串缓冲区下操作大量数据: 适用
StringBuffer
2. String 为什么是不可变的?
String 类中使用 final 关键字修饰字符数组来保存字符串,所以String 对象是不可变的。
public final class String implements java.io.Serializable, Comparable<String>, CharSequence {
    private final char value[];
  //...
}
🐛 修正:我们知道被
final关键字修饰的类不能被继承,修饰的方法不能被重写,修饰的变量是基本数据类型则值不能改变,修饰的变量是引用类型则不能再指向其他对象。因此,final关键字修饰的数组保存字符串并不是String不可变的根本原因,因为这个数组保存的字符串是可变的(final修饰引用类型变量的情况)。
String真正不可变有下面几点原因:
- 保存字符串的数组被
final修饰且为私有的,并且String类没有提供/暴露修改这个字符串的方法。String类被final修饰导致其不能被继承,进而避免了子类破坏String不可变。相关阅读:如何理解 String 类型值的不可变? - 知乎提问
补充(来自issue 675):在 Java 9 之后,
String、StringBuilder与StringBuffer的实现改用byte数组存储字符串。public final class String implements java.io.Serializable,Comparable<String>, CharSequence {
// @Stable 注解表示变量最多被修改一次,称为“稳定的”。
@Stable
private final byte[] value;
}
abstract class AbstractStringBuilder implements Appendable, CharSequence {
byte[] value;
}Java 9 为何要将
String的底层实现由char[]改成了byte[]?新版的 String 其实支持两个编码方案:Latin-1 和 UTF-16。如果字符串中包含的汉字没有超过 Latin-1 可表示范围内的字符,那就会使用 Latin-1 作为编码方案。Latin-1 编码方案下,
byte占一个字节(8 位),char占用 2 个字节(16),byte相较char节省一半的内存空间。JDK 官方就说了绝大部分字符串对象只包含 Latin-1 可表示的字符。
如果字符串中包含的汉字超过 Latin-1 可表示范围内的字符,
byte和char所占用的空间是一样的。这是官方的介绍:https://openjdk.java.net/jeps/254 。
3. 字符串拼接用“+” 还是 StringBuilder?
Java 语言本身并不支持运算符重载,“+”和“+=”是专门为 String 类重载过的运算符,也是 Java 中仅有的两个重载过的运算符。
String str1 = "he";
String str2 = "llo";
String str3 = "world";
String str4 = str1 + str2 + str3;
上面的代码对应的字节码如下:
可以看出,字符串对象通过“+”的字符串拼接方式,实际上是通过 StringBuilder 调用 append() 方法实现的,拼接完成之后调用 toString() 得到一个 String 对象 。
不过,在循环内使用“+”进行字符串的拼接的话,存在比较明显的缺陷:编译器不会创建单个 StringBuilder 以复用,会导致创建过多的 StringBuilder 对象。
String[] arr = {"he", "llo", "world"};
String s = "";
for (int i = 0; i < arr.length; i++) {
    s += arr[i];
}
System.out.println(s);
StringBuilder 对象是在循环内部被创建的,这意味着每循环一次就会创建一个 StringBuilder 对象。
如果直接使用 StringBuilder 对象进行字符串拼接的话,就不会存在这个问题了。
String[] arr = {"he", "llo", "world"};
StringBuilder s = new StringBuilder();
for (String value : arr) {
    s.append(value);
}
System.out.println(s);
如果你使用 IDEA 的话,IDEA 自带的代码检查机制也会提示你修改代码。
在 JDK 9 中,字符串相加“+”改为用动态方法 makeConcatWithConstants() 来实现,通过提前分配空间从而减少了部分临时对象的创建。然而这种优化主要针对简单的字符串拼接,如: a+b+c 。对于循环中的大量拼接操作,仍然会逐个动态分配内存(类似于两个两个 append 的概念),并不如手动使用 StringBuilder 来进行拼接效率高。这个改进是 JDK9 的 JEP 280 提出的,关于这部分改进的详细介绍,推荐阅读这篇文章:还在无脑用 StringBuilder?来重温一下字符串拼接吧 以及参考 issue#2442。
4. String#equals() 和 Object#equals() 有何区别?
String 中的 equals 方法是被重写过的,比较的是 String 字符串的值是否相等。 Object 的 equals 方法是比较的对象的内存地址。
5. 字符串常量池的作用了解吗?
字符串常量池 是 JVM 为了提升性能和减少内存消耗针对字符串(String 类)专门开辟的一块区域,主要目的是为了避免字符串的重复创建。
// 在字符串常量池中创建字符串对象 ”ab“
// 将字符串对象 ”ab“ 的引用赋值给 aa
String aa = "ab";
// 直接返回字符串常量池中字符串对象 ”ab“,赋值给引用 bb
String bb = "ab";
System.out.println(aa==bb); // true
6. String s1 = new String("abc");这句话创建了几个字符串对象?
先说答案:会创建 1 或 2 个字符串对象。
- 字符串常量池中不存在 "abc":会创建 2 个 字符串对象。一个在字符串常量池中,由
ldc指令触发创建。一个在堆中,由new String()创建,并使用常量池中的 "abc" 进行初始化。 - 字符串常量池中已存在 "abc":会创建 1 个 字符串对象。该对象在堆中,由
new String()创建,并使用常量池中的 "abc" 进行初始化。
下面开始详细分析。
1、如果字符串常量池中不存在字符串对象 “abc”,那么它首先会在字符串常量池中创建字符串对象 "abc",然后在堆内存中再创建其中一个字符串对象 "abc"。
示例代码(JDK 1.8):
String s1 = new String("abc");
对应的字节码:
// 在堆内存中分配一个尚未初始化的 String 对象。
// #2 是常量池中的一个符号引用,指向 java/lang/String 类。
// 在类加载的解析阶段,这个符号引用会被解析成直接引用,即指向实际的 java/lang/String 类。
0 new #2 <java/lang/String>
// 复制栈顶的 String 对象引用,为后续的构造函数调用做准备。
// 此时操作数栈中有两个相同的对象引用:一个用于传递给构造函数,另一个用于保持对新对象的引用,后续将其存储到局部变量表。
3 dup
// JVM 先检查字符串常量池中是否存在 "abc"。
// 如果常量池中已存在 "abc",则直接返回该字符串的引用;
// 如果常量池中不存在 "abc",则 JVM 会在常量池中创建该字符串字面量并返回它的引用。
// 这个引用被压入操作数栈,用作构造函数的参数。
4 ldc #3 <abc>
// 调用构造方法,使用从常量池中加载的 "abc" 初始化堆中的 String 对象
// 新的 String 对象将包含与常量池中的 "abc" 相同的内容,但它是一个独立的对象,存储于堆中。
6 invokespecial #4 <java/lang/String.<init> : (Ljava/lang/String;)V>
// 将堆中的 String 对象引用存储到局部变量表
9 astore_1
// 返回,结束方法
10 return
ldc (load constant) 指令的确是从常量池中加载各种类型的常量,包括字符串常量、整数常量、浮点数常量,甚至类引用等。对于字符串常量,ldc 指令的行为如下:
- 从常量池加载字符串:
ldc首先检查字符串常量池中是否已经有内容相同的字符串对象。 - 复用已有字符串对象:如果字符串常量池中已经存在内容相同的字符串对象,
ldc会将该对象的引用加载到操作数栈上。 - 没有则创建新对象并加入常量池:如果字符串常量池中没有相同内容的字符串对象,JVM 会在常量池中创建一个新的字符串对象,并将其引用加载到操作数栈中。
2、如果字符串常量池中已存在字符串对象“abc”,则只会在堆中创建 1 个字符串对象“abc”。
示例代码(JDK 1.8):
// 字符串常量池中已存在字符串对象“abc”
String s1 = "abc";
// 下面这段代码只会在堆中创建 1 个字符串对象“abc”
String s2 = new String("abc");
对应的字节码:
0 ldc #2 <abc>
2 astore_1
3 new #3 <java/lang/String>
6 dup
7 ldc #2 <abc>
9 invokespecial #4 <java/lang/String.<init> : (Ljava/lang/String;)V>
12 astore_2
13 return
这里就不对上面的字节码进行详细注释了,7 这个位置的 ldc 命令不会在堆中创建新的字符串对象“abc”,这是因为 0 这个位置已经执行了一次 ldc 命令,已经在堆中创建过一次字符串对象“abc”了。7 这个位置执行 ldc 命令会直接返回字符串常量池中字符串对象“abc”对应的引用。
7. String#intern 方法有什么作用?
String.intern() 是一个 native (本地) 方法,用来处理字符串常量池中的字符串对象引用。它的工作流程可以概括为以下两种情况:
- 常量池中已有相同内容的字符串对象:如果字符串常量池中已经有一个与调用
intern()方法的字符串内容相同的String对象,intern()方法会直接返回常量池中该对象的引用。 - 常量池中没有相同内容的字符串对象:如果字符串常量池中还没有一个与调用
intern()方法的字符串内容相同的对象,intern()方法会将当前字符串对象的引用添加到字符串常量池中,并返回该引用。
总结:
intern()方法的主要作用是确保字符串引用在常量池中的唯一性。- 当调用
intern()时,如果常量池中已经存在相同内容的字符串,则返回常量池中已有对象的引用;否则,将该字符串添加到常量池并返回其引用。
示例代码(JDK 1.8) :
// s1 指向字符串常量池中的 "Java" 对象
String s1 = "Java";
// s2 也指向字符串常量池中的 "Java" 对象,和 s1 是同一个对象
String s2 = s1.intern();
// 在堆中创建一个新的 "Java" 对象,s3 指向它
String s3 = new String("Java");
// s4 指向字符串常量池中的 "Java" 对象,和 s1 是同一个对象
String s4 = s3.intern();
// s1 和 s2 指向的是同一个常量池中的对象
System.out.println(s1 == s2); // true
// s3 指向堆中的对象,s4 指向常量池中的对象,所以不同
System.out.println(s3 == s4); // false
// s1 和 s4 都指向常量池中的同一个对象
System.out.println(s1 == s4); // true
8. String 类型的变量和常量做“+”运算时发生了什么?
先来看字符串不加 final 关键字拼接的情况(JDK1.8):
String str1 = "str";
String str2 = "ing";
String str3 = "str" + "ing";
String str4 = str1 + str2;
String str5 = "string";
System.out.println(str3 == str4);//false
System.out.println(str3 == str5);//true
System.out.println(str4 == str5);//false
注意:比较 String 字符串的值是否相等,可以使用
equals()方法。String中的equals方法是被重写过的。Object的equals方法是比较的对象的内存地址,而String的equals方法比较的是字符串的值是否相等。如果你使用==比较两个字符串是否相等的话,IDEA 还是提示你使用equals()方法替换。
对于编译期可以确定值的字符串,也就是常量字符串 ,jvm 会将其存入字符串常量池。并且,字符串常量拼接得到的字符串常量在编译阶段就已经被存放字符串常量池,这个得益于编译器的优化。
在编译过程中,Javac 编译器(下文中统称为编译器)会进行一个叫做 常量折叠(Constant Folding) 的代码优化。《深入理解 Java 虚拟机》中是也有介绍到:
常量折叠会把常量表达式的值求出来作为常量嵌在最终生成的代码中,这是 Javac 编译器会对源代码做的极少量优化措施之一(代码优化几乎都在即时编译器中进行)。
对于 String str3 = "str" + "ing"; 编译器会给你优化成 String str3 = "string"; 。
并不是所有的常量都会进行折叠,只有编译器在程序编译期就可以确定值的常量才可以:
- 基本数据类型(
byte、boolean、short、char、int、float、long、double)以及字符串常量。 final修饰的基本数据类型和字符串变量- 字符串通过 “+”拼接得到的字符串、基本数据类型之间算数运算(加减乘除)、基本数据类型的位运算(<<、>>、>>> )
引用的值在程序编译期是无法确定的,编译器无法对其进行优化。
对象引用和“+”的字符串拼接方式,实际上是通过 StringBuilder 调用 append() 方法实现的,拼接完成之后调用 toString() 得到一个 String 对象 。
String str4 = new StringBuilder().append(str1).append(str2).toString();
我们在平时写代码的时候,尽量避免多个字符串对象拼接,因为这样会重新创建对象。如果需要改变字符串的话,可以使用 StringBuilder 或者 StringBuffer。
不过,字符串使用 final 关键字声明之后,可以让编译器当做常量来处理。
示例代码:
final String str1 = "str";
final String str2 = "ing";
// 下面两个表达式其实是等价的
String c = "str" + "ing";// 常量池中的对象
String d = str1 + str2; // 常量池中的对象
System.out.println(c == d);// true
被 final 关键字修饰之后的 String 会被编译器当做常量来处理,编译器在程序编译期就可以确定它的值,其效果就相当于访问常量。
如果 ,编译器在运行时才能知道其确切值的话,就无法对其优化。
示例代码(str2 在运行时才能确定其值):
final String str1 = "str";
final String str2 = getStr();
String c = "str" + "ing";// 常量池中的对象
String d = str1 + str2; // 在堆上创建的新的对象
System.out.println(c == d);// false
public static String getStr() {
      return "ing";
}